Veröffentlicht am 27. Oktober 2026
Bedeuten KI-Crawler-Besuche, dass ein Assistent Ihr Unternehmen weiterempfiehlt?
Eine Crawler-Anfrage zeigt, dass ein Client Ihren Server nach einer Ressource gefragt hat; Es bedeutet nicht, dass ein Assistent Ihr Unternehmen benennt oder empfiehlt. Verschiedene Crawler dienen unterschiedlichen Zwecken. Sehen Sie sich die aktuelle Dokumentation des Anbieters an, verifizieren Sie einen verdächtigen Bot mithilfe der veröffentlichten Methode und unterscheiden Sie zwischen robots.txt-Regeln und Firewall-Verhalten. Überprüfen Sie dann vollständige Antworten auf eine konsistente Kundenfrage, anstatt die Anzahl der Besuche in einen Empfehlungswert umzuwandeln.
Eine Anfrage ist keine Empfehlung
Ein Serverprotokoll kann eine Uhrzeit, eine URL, einen Statuscode und einen beanspruchten Benutzeragenten aufzeichnen. Es ist ein betrieblicher Beweis dafür, dass eine Anfrage den Server oder Edge erreicht hat, und kein Beweis dafür, dass die Seite indiziert, zum Trainieren eines Modells verwendet, als Quelle ausgewählt oder einem Kunden angezeigt wurde. Eine erfolgreiche Antwort auf eine Homepage sagt allein noch nichts darüber aus, ob die konkrete Serviceseite aufgerufen wurde. Eine fehlende Zeile hat auch Grenzen: Ein Anbieter verwendet möglicherweise einen Index, eine andere Quelle, einen Cache oder eine Infrastruktur, deren Protokolle Sie nicht sehen können.
User-Agent-Strings können nachgeahmt werden. Bevor Sie den Datenverkehr als offiziellen Crawler bezeichnen, verwenden Sie die Überprüfungsmethode und die veröffentlichten Adressen in der Dokumentation dieses Anbieters. Ändern Sie eine Firewall-Regel nicht nur, weil in einer Anfrage angegeben wird, dass es sich um einen bestimmten Bot handelt. Überprüfen Sie die Statuscodes und den genauen angeforderten Pfad mit der für die Site verantwortlichen Person. Eine Ratenbegrenzung, eine Umleitung, eine Zugriffsrichtlinie oder ein Serverfehler können eine fehlgeschlagene Anfrage erklären, ohne zu beweisen, was ein Assistent geantwortet hätte.
Unterschiedliche Zwecke erfordern unterschiedliche Entscheidungen
Die Crawler-Dokumentation von OpenAI unterscheidet OAI-SearchBot, der für die Sucherkennung verwendet wird, von GPTBot, der mit Inhalten verknüpft ist, die zum Training von Modellen verwendet werden können. ChatGPT-User ist mit vom Benutzer ausgelösten Anfragen verknüpft. Diese Labels beschreiben die erklärten Zwecke des Anbieters und sind keine universelle Taxonomie für jedes Unternehmen. Entscheidungen über Suchzugriff und Modelltraining sind unterschiedliche Entscheidungen; Gehen Sie nicht davon aus, dass die Zulassung eines Benutzeragenten automatisch jede Nutzung autorisiert oder die Aufnahme in die Suchergebnisse garantiert.
Eine robots.txt-Richtlinie kommuniziert Crawling-Einstellungen an konforme Crawler. Es handelt sich nicht um ein Zugangskontrollsystem oder einen Geheimhaltungsmechanismus. Eine Firewall oder ein Login kann eine Anfrage blockieren, selbst wenn Robots dies zulassen. Um den Zugriff auf wirklich private Informationen zu verhindern, verwenden Sie umgekehrt geeignete Zugriffskontrollen. Google erklärt außerdem, dass das Blockieren des Crawlings nicht dasselbe ist wie das Verhindern der Indexierung einer URL; Der dokumentierte noindex-Mechanismus muss für den Crawler zugänglich sein, damit er gelesen werden kann.
Überprüfen Sie die Route, bevor Sie eine Richtlinie ändern
Beginnen Sie mit der öffentlichen Seite, die die eigentliche Frage des Kunden beantwortet. Überprüfen Sie die finale URL nach Weiterleitungen, den Antwortcode, sichtbare Service-Fakten und ob wichtige Inhalte für den beabsichtigten Besucher verfügbar sind. Überprüfen Sie die relevanten Robots-Regeln und, zusammen mit dem Website-Betreiber, alle CDN- oder Firewall-Protokolle. Behalten Sie die vorherige Konfiguration bei und identifizieren Sie ein Rollback, bevor Sie den Zugriff ändern. Eine allgemeine Zulassungsregel kann sich auf mehr Pfade als die Seite auswirken, die Sie freigeben wollten.
Entscheiden Sie, welchen Anbieter und welche Nutzung Sie tatsächlich aktivieren möchten, und dokumentieren Sie den Kompromiss mit dem Geschäftsinhaber. Ein bezahlter Eintrag, ein Crawler-Besuch oder eine erfolgreiche Seitenanfrage sind kein Empfehlungsversprechen. Wenn ein Anbieter separate Kontrollen für Suche und Modelltraining dokumentiert, werten Sie diese separat aus. Wenn die Serviceseite selbst falsch ist oder das Unternehmen die Frage nicht beantworten kann, beheben Sie das Problem, anstatt zu versuchen, dies durch Bot-Traffic zu kompensieren.
Ausgearbeitetes Beispiel: eine fiktive Reparaturfirma
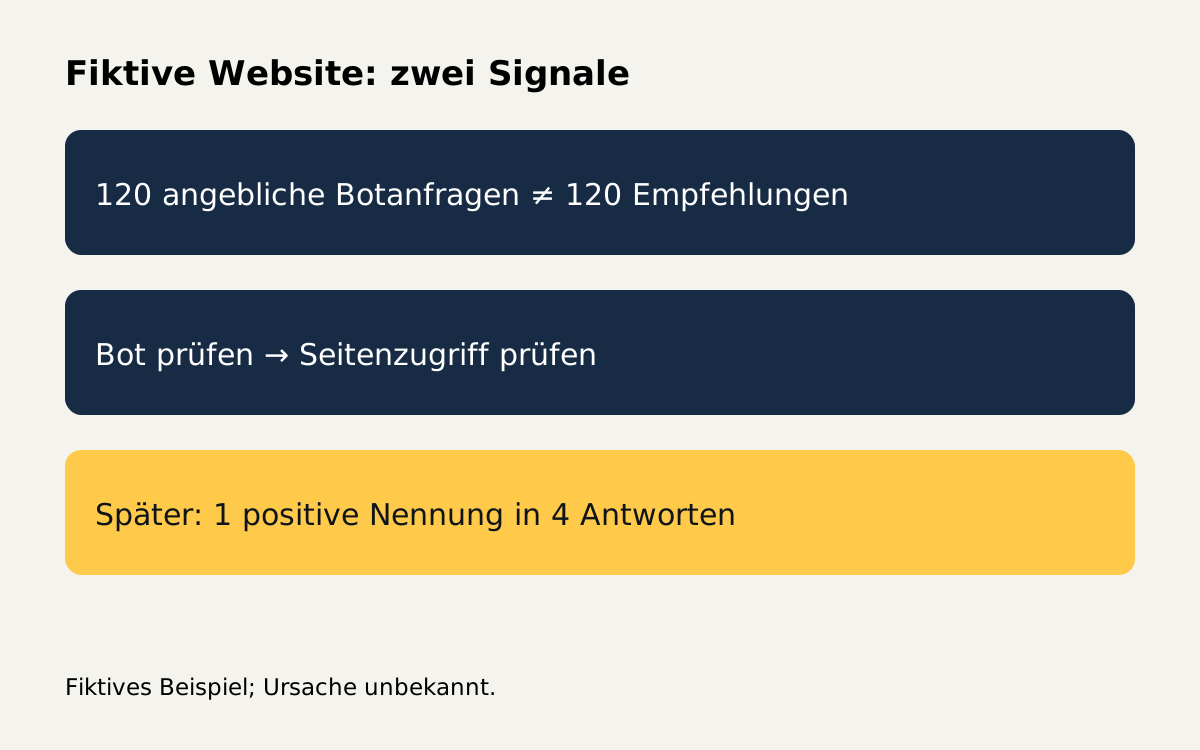
Dies ist ein hypothetisches Beispiel, kein sayurname-Kunde und kein gemessenes Ergebnis. Ridge Window Repair beschäftigt vier Techniker in einer Stadt und hat eine öffentliche Seite zur Reparatur von Lecks. Der Inhaber sieht in einem Dashboard, dass ein angeblicher KI-Bot die Startseite im Monat 120-mal anforderte, und erwartet deshalb eine Empfehlung. Das Team prüft die Aussagekraft der Zahl ohne private Kundendaten zu öffnen.
Das Team speichert eine Ausgangsbasis für eine Frage ohne Firmennamen zu einem undichten Fenster in seiner Stadt. In diesem erfundenen Lauf nennt keiner der vier verfügbaren Assistenten Ridge positiv; Einer verlinkt auf die Serviceseite als Quelle, zwei nennen andere Unternehmen und einer gibt allgemeine Ratschläge. Der Quelllink ist kein Name in der Antwort. Die Protokollanzahl und dieser eine Antwortsatz beschreiben unterschiedliche Dinge. Keiner begründet die Ursache des anderen.
- Erfassen Sie die genaue Kundenfrage, Stadt, Sprache, Datum, Assistenten, sichtbare Sucheinstellungen und vollständige Antworten. Markieren Sie eine fehlende Antwort als nicht verfügbar. Halten Sie die Anzahl der verfügbaren Antworten neben der Zahl, die das Unternehmen positiv benennt, und erfassen Sie reine Quellenlinks separat.
- Bitten Sie den Site-Betreiber um ein begrenztes Protokollbeispiel mit Pfaden, Zeiten, Antwortcodes und beanspruchten Benutzeragenten. Vermeiden Sie den Export von Patientenakten, Anmeldeinformationen oder unnötigen Besucherdaten. Überprüfen Sie den verdächtigen Crawler anhand der veröffentlichten Prozedur und Adressbereiche des Anbieters, bevor Sie ihm den Datenverkehr zuordnen.
- Überprüfen Sie die wichtige Service-URL, nicht nur die Homepage. Im fiktiven Beispiel lässt eine Robots-Regel den Such-Crawler zu, aber eine CDN-Regel gibt 403 für diesen verifizierten Crawler auf der Serviceseite zurück. Ein separater Trainings-Crawler hat seine eigene Richtlinie. Das Protokoll stellt die beobachtete Antwort für diese Anfrage fest; es beweist nicht, dass die Seite andernfalls ausgewählt würde.
- Lassen Sie den Eigentümer entscheiden, welcher Zugang vorgesehen ist. Wenn Suchzugriff gewünscht ist, nehmen Sie mit dem Site-Betreiber eine eng begrenzte CDN-Korrektur vor und halten Sie einen Rücksetzplan bereit. Ändern Sie die einzelnen Trainingspräferenzen nicht nur als Nebeneffekt. Bestätigen Sie die endgültige Antwort für den verifizierten Crawler mithilfe der vom Anbieter unterstützten Verifizierungsmethode.
- Wiederholen Sie die unveränderte Frage regelmäßig und speichern Sie alle verfügbaren Antworten. In einer späteren fiktiven Messung nennt einer von vier Assistenten Ridge positiv. Halten Sie alle reinen Quelllinks und nicht verfügbaren Ergebnisse getrennt. Eine negative Erwähnung ist keine positive Empfehlung.
- Überprüfen Sie gemeinsam die Konfigurationsänderung, den verifizierten Zugriff und die vollständige Antwortreihe. Die Änderung von null auf einen Namen in zwei erfundenen Läufen beweist nicht, dass die CDN-Korrektur den Namen verursacht hat, stellt keine Wahrscheinlichkeit für jeden Benutzer fest und zeigt keinen Verkauf an. Andere Seiten, Indizes, Modelle und Einstellungen können sich geändert haben.
Wenn die Website einen Crawler aus geschäftlichen, datenschutzrechtlichen oder lizenzrechtlichen Gründen absichtlich einschränkt, dürfen Sie diese Entscheidung nicht außer Kraft setzen, nur um die im Dashboard angezeigte Anzahl zu erhöhen. Fragen Sie, ob eine öffentliche Teilmenge oder eine andere dokumentierte Route den Zweck erfüllt. Die Identität und Verwendung eines Crawlers kann sich ändern. Konsultieren Sie daher die aktuelle Dokumentation des Anbieters, bevor Sie die Richtlinie bearbeiten.
Ein positive Nennung in einer Antwort, ein Quelllink, ein im verbundenen Analytics erfasster KI-Besuch und eine Bot-Anfrage sind separate Signale. Jeder kann eine andere betriebliche Frage beantworten. Ein Protokoll ist für die Zugriffsdiagnose hilfreich; Es ist kein verlässlicher Indikator für das Geschäftsergebnis.
Quellen und Überprüfung
OpenAI beschreibt seine Crawler-Zwecke und Verifizierungsinformationen unter https://developers.openai.com/api/docs/bots. Google erklärt den Unterschied zwischen Crawling und Indexierung unter https://developers.google.com/search/docs/crawling-indexing/googlebot und dokumentiert noindex unter https://developers.google.com/search/docs/crawling-indexing/block-indexing. Diese Dokumente sind anbieterspezifisch; Überprüfen Sie andere Anbieter separat, anstatt eine Regel zu verallgemeinern.
Bewahren Sie die aktuelle Anfrage, das Überprüfungsergebnis, die relevante Konfiguration und die Daten auf. Wenn der beanspruchte Agent nicht verifiziert werden kann, kennzeichnen Sie ihn als nicht verifiziert. Wenn eine Assistentenantwort keine sichtbaren Quellen hat oder nicht abgerufen werden kann, notieren Sie diese Einschränkung, anstatt einen Zusammenhang zwischen einer Anfrage und einer Empfehlung zu erfinden. Vergleichen Sie nur die Fragen und Einstellungen, die Sie sinnvollerweise zuordnen können.
Wie sayurname arbeitet
Der kostenlose Test stellt eine Frage an ChatGPT, Gemini, Perplexity und Claude und speichert die verfügbaren Antworten. Nach dem Abo bearbeitet sayurname die Fragen, beantragt, wo möglich, die Aufnahme in Quellen und misst wöchentlich. Der Preis beträgt 299 US$ pro Monat ohne Mindestlaufzeit. Ein einmaliger Bonus von 599 US$ kann fällig werden, wenn das Unternehmen bei einer gemessenen Frage erstmals positiv genannt wird, bei der es zu Beginn fehlte, oder wenn das verbundene Google Analytics während der Leistung einen KI-Besuch erfasst. Ein Teammitglied prüft den Beleg vor der Abrechnung. Kein Ergebnis ist garantiert.
Fragen
Garantiert ein verifizierter Crawler-Besuch eine Empfehlung?
Nein. Er zeigt eine Anfrage eines verifizierten Crawlers und belegt nicht, was ein Assistent sagen wird.
Sind Such- und Trainings-Crawler notwendigerweise dasselbe?
Nein. OpenAI dokumentiert separate Benutzeragenten für verschiedene Zwecke. Prüfen Sie die aktuelle Dokumentation des jeweiligen Anbieters und Ihre eigenen Zugangspräferenzen.
Macht das Blockieren eines Crawlers eine Seite privat?
Nein. robots.txt-Regeln stellen keine Zugangskontrolle dar. Verwenden Sie geeignete Authentifizierungs- oder andere Zugriffskontrollen für private Inhalte.
Was sollte ich neben den Protokollen messen?
Speichern Sie vollständige datierte Antworten auf vergleichbare Fragen. Erfassen Sie Nennungen, reine Quellenlinks und nicht verfügbare Antworten getrennt. Verbundenes Analytics liefert ein anderes Signal über Besuche.