Publicado el 27 de octubre de 2026
¿Las visitas al rastreador de IA significan que un asistente recomendará su empresa?
Una solicitud de rastreador muestra que un cliente solicitó un recurso a su servidor; no demuestra que un asistente nombrará o recomendará su empresa. Los diferentes rastreadores tienen diferentes propósitos. Consulte la documentación actual del proveedor, verifique un bot sospechoso utilizando su método publicado y distinga las reglas de los robots del comportamiento del firewall. Luego, inspeccione las respuestas completas a una pregunta constante de un cliente en lugar de convertir el recuento de visitas en una puntuación de recomendación.
Una solicitud no es una recomendación.
Un registro del servidor puede registrar una hora, una URL, un código de estado y un agente de usuario declarado. Es una prueba operativa de que una solicitud llegó al servidor o al borde, no una prueba de que la página fue indexada, utilizada para entrenar un modelo, seleccionada como fuente o mostrada a un cliente. Una respuesta exitosa para una página de inicio no dice nada por sí sola sobre si se recuperó la página de servicio específica. Una línea faltante también tiene límites: un proveedor puede usar un índice, otra fuente, un caché o una infraestructura cuyos registros no puedes ver.
Las cadenas de usuario-agente se pueden imitar. Antes de llamar al tráfico un rastreador oficial, utilice el método de verificación y las direcciones publicadas en la documentación de ese proveedor. No cambie una regla de firewall únicamente porque una solicitud indique que se trata de un bot en particular. Revisar los códigos de estado y la ruta exacta solicitada con el responsable del sitio; un límite de velocidad, una redirección, una política de acceso o un error del servidor pueden explicar una solicitud fallida sin demostrar lo que habría respondido un asistente.
Diferentes propósitos requieren diferentes decisiones
La documentación del rastreador de OpenAI distingue OAI-SearchBot, utilizado para el descubrimiento de búsquedas, de GPTBot, asociado con contenido que puede usarse para entrenamiento. ChatGPT-User está asociado con solicitudes activadas por el usuario. Estas etiquetas describen los propósitos declarados del proveedor, no una taxonomía universal para todas las empresas. Las decisiones sobre el acceso a la búsqueda y el entrenamiento son distintas; No asuma que permitir un agente de usuario autoriza automáticamente cada uso o garantiza la inclusión en los resultados de búsqueda.
Una política de robots.txt comunica las preferencias de rastreo a los rastreadores compatibles; no es un sistema de control de acceso ni un mecanismo de secreto. Un firewall o un inicio de sesión pueden bloquear una solicitud incluso si los robots lo permiten. Por el contrario, para evitar el acceso a información genuinamente privada, utilice controles de acceso adecuados. Google también explica que bloquear el rastreo no es lo mismo que impedir que se indexe una URL; su mecanismo noindex documentado debe ser accesible para que el rastreador pueda leerlo.
Consulta la ruta antes de cambiar una política
Comience con la página pública que responde a la pregunta real del cliente. Verifique la URL final después de las redirecciones, el código de respuesta, los datos visibles del servicio y si hay contenido importante disponible para el visitante previsto. Inspeccione las reglas de robots relevantes y, con el operador del sitio, cualquier registro de CDN o firewall. Conserve la configuración anterior e identifique una reversión antes de cambiar el acceso. Una regla de permiso amplia puede afectar a más rutas que la página que pretendía exponer.
Decida qué proveedor y uso desea habilitar realmente y documente la compensación con el propietario de la empresa. Un listado pagado, una visita de un rastreador o una solicitud de página exitosa no son una promesa de recomendación. Si un proveedor documenta controles de búsqueda y capacitación separados, evalúelos por separado. Si la página de servicio en sí es incorrecta o la empresa no puede atender la pregunta, solucione ese problema en lugar de intentar compensarlo con tráfico de bots.
Ejemplo resuelto: una empresa de reparaciones ficticia
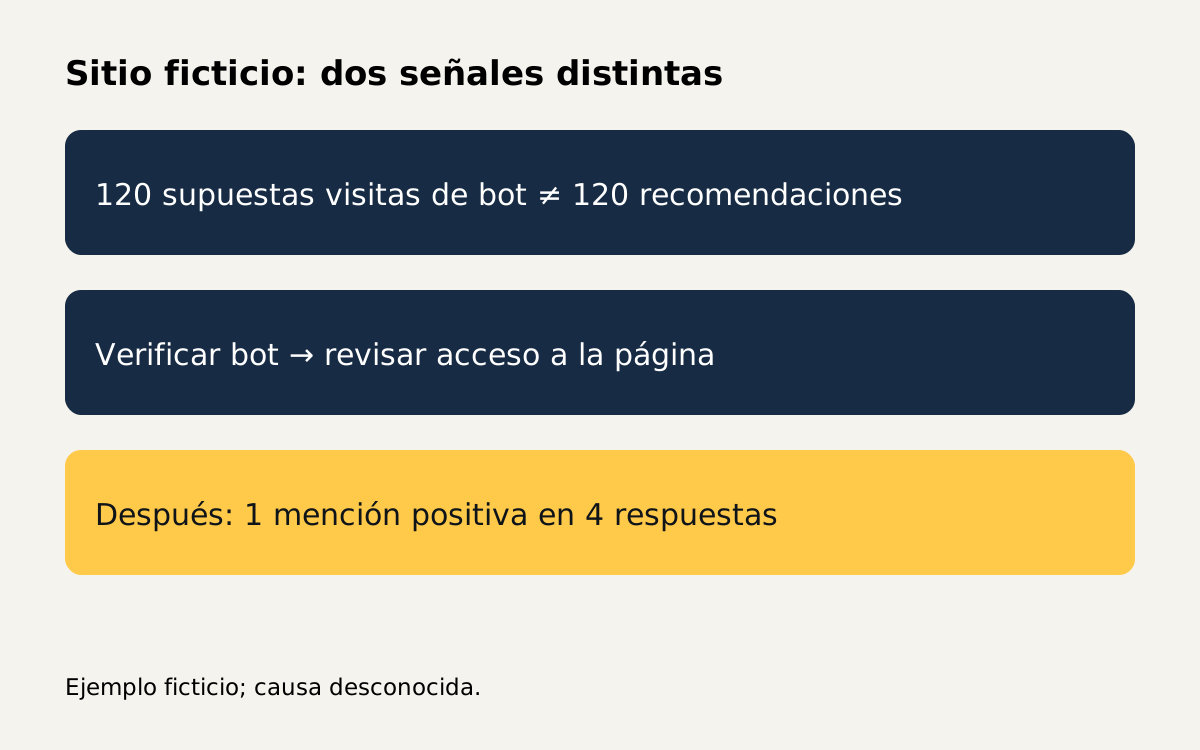
Este es un ejemplo hipotético, no es cliente de sayurname ni un resultado medido. Ridge Window Repair tiene cuatro técnicos en una ciudad y una página pública sobre reparación de filtraciones. El dueño ve en un panel que un supuesto bot de IA solicitó la portada 120 veces en el mes y supone que el negocio debería ser recomendado. El equipo quiere saber qué demuestra el número sin abrir registros privados de clientes.
El equipo guarda una línea de base para una pregunta sin marca sobre una ventana con fugas en su ciudad. En esta medición ficticia, ninguno de los cuatro asistentes disponibles nombra a Ridge positivamente; uno enlaza a la página del servicio como fuente, dos nombran otras empresas y uno brinda consejos generales. El enlace de la fuente no es un nombre en la respuesta. El recuento de registros y ese conjunto de respuestas describen cosas diferentes; ninguno establece la causa del otro.
- Registre la pregunta exacta del cliente, ciudad, idioma, fecha, asistentes, configuraciones de búsqueda visibles y respuestas completas. Marca una respuesta faltante como no disponible. Mantenga la cantidad de respuestas disponibles junto al número que nombra positivamente a la empresa y registre los enlaces de solo fuente por separado.
- Solicite al operador del sitio una muestra de registro limitada que muestre rutas, tiempos, códigos de respuesta y agentes de usuario declarados. Evite exportar registros de pacientes, credenciales o datos de visitantes innecesarios. Verifique el rastreador sospechoso con el procedimiento publicado por el proveedor y los rangos de direcciones antes de atribuirle el tráfico.
- Verifique la URL del servicio importante, no solo la página de inicio. En la muestra ficticia, una regla de robots permite el rastreador de búsqueda, pero una regla de CDN devuelve 403 para ese rastreador verificado en la página de servicio. Un rastreador de entrenamiento independiente tiene su propia política. El registro establece la respuesta observada para esa solicitud; no prueba que, de lo contrario, la página sería seleccionada.
- Haga que el propietario decida qué acceso se pretende. Si desea acceso de búsqueda, realice una corrección CDN de alcance limitado con el operador del sitio y mantenga una reversión. No cambie la preferencia de entrenamiento por separado simplemente como efecto secundario. Confirme la respuesta final del rastreador verificado utilizando el método de verificación admitido por el proveedor.
- Repita la pregunta sin cambios de forma regular y guarde todas las respuestas disponibles. En una versión ficticia posterior, uno de los cuatro nombra a Ridge positivamente. Mantenga separados los enlaces de origen exclusivo y los resultados no disponibles; una mención negativa no es una recomendación positiva.
- Revise juntos el cambio de configuración, el acceso verificado y la serie de respuestas completa. El cambio de cero a un nombre en dos mediciones ficticias no prueba que la corrección CDN causó el nombre, no establece una probabilidad para cada usuario ni muestra una venta. Es posible que otras páginas, índices, modelos y configuraciones hayan cambiado.
Si el sitio restringe deliberadamente un rastreador por motivos comerciales, de privacidad o de licencia, no anule esa decisión simplemente para aumentar el recuento del panel. Pregunte si un subconjunto público u otra ruta documentada sirve para ese propósito. La identidad y el uso de un rastreador pueden cambiar, así que consulte la documentación actual del proveedor antes de editar la política.
Una mención positiva en una respuesta, un enlace de la fuente, una visita remitida por IA registrada por análisis conectados y una solicitud de bot son señales separadas. Cada uno puede responder a una pregunta operativa diferente. Un registro es útil para diagnosticar el acceso; no es un indicador fiable del resultado empresarial.
Fuentes y verificación
OpenAI describe los propósitos de su rastreador y la información de verificación en https://developers.openai.com/api/docs/bots. Google explica la distinción entre rastreo e indexación en https://developers.google.com/search/docs/crawling-indexing/googlebot y documenta noindex en https://developers.google.com/search/docs/crawling-indexing/block-indexing. Esos documentos son específicos de cada proveedor; consulte otros proveedores por separado en lugar de generalizar una regla.
Conserve la solicitud real, el resultado de la verificación, la configuración y las fechas relevantes. Si el agente declarado no se puede verificar, etiquételo como no verificado. Si la respuesta de un asistente no tiene fuentes visibles o no se puede obtener, registre esa limitación en lugar de inventar un vínculo entre una solicitud y una recomendación. Compare sólo las preguntas y configuraciones que pueda coincidir razonablemente.
Cómo trabaja sayurname
La prueba gratuita envía una pregunta a ChatGPT, Gemini, Perplexity y Claude y guarda las respuestas disponibles. Tras la suscripción, sayurname trabaja las preguntas, solicita inclusión en fuentes cuando existe una vía y mide semanalmente. La cuota es US$ 299 al mes sin permanencia. Puede cobrarse un bono único de US$ 599 si la empresa pasa a ser mencionada positivamente en una pregunta medida donde estaba ausente al inicio, o si Google Analytics conectado registra una visita de IA durante el servicio. Una persona del equipo verifica la prueba antes del cobro. Ningún resultado está garantizado.
Preguntas
¿Una visita de un rastreador verificado garantiza una recomendación?
No. Muestra una solicitud realizada por un rastreador verificado; no establece lo que dirá un asistente.
¿Los rastreadores de búsqueda y de entrenamiento son necesariamente iguales?
No. Los documentos de OpenAI separan los agentes de usuario para diferentes propósitos. Consulte la documentación actual del proveedor correspondiente y sus propias preferencias de acceso.
¿Bloquear un rastreador hace que una página sea privada?
No. Las reglas de los robots no son control de acceso. Utilice autenticación adecuada u otros controles de acceso para contenido privado.
¿Qué debo medir junto con los registros?
Guarda las respuestas completas y fechadas a preguntas comparables. Registra por separado las menciones, los enlaces que aparecen solo en las fuentes y las respuestas no disponibles. El Analytics conectado puede aportar otra señal sobre las visitas.