Publié le 27 octobre 2026
Les visites des robots d’IA signifient-elles qu’un assistant recommandera votre entreprise ?
Une requête de robot d'exploration montre qu'un client a demandé une ressource à votre serveur ; cela ne montre pas qu'un assistant nommera ou recommandera votre entreprise. Différents robots d'exploration servent à des fins différentes. Consultez la documentation actuelle du fournisseur, vérifiez un robot suspecté à l'aide de sa méthode publiée et distinguez les règles des robots du comportement du pare-feu. Inspectez ensuite les réponses complètes à une question client cohérente plutôt que de transformer le nombre de visites en score de recommandation.
Une demande n'est pas une recommandation
Un journal de serveur peut enregistrer une heure, une URL, un code d'état et l'agent utilisateur revendiqué. Il s'agit d'une preuve opérationnelle qu'une requête a atteint le serveur ou en périphérie, et non une preuve que la page a été indexée, utilisée pour entraîner un modèle, sélectionnée comme source ou présentée à un client. Une réponse réussie pour une page d'accueil ne dit rien en soi sur la question de savoir si la page de service spécifique a été récupérée. Une ligne manquante a aussi des limites : un fournisseur peut utiliser un index, une autre source, un cache ou une infrastructure dont vous ne pouvez pas voir les logs.
Les chaînes de l'agent utilisateur peuvent être imitées. Avant d’appeler le trafic un robot d’exploration officiel, utilisez la méthode de vérification et les adresses publiées dans la documentation de ce fournisseur. Ne modifiez pas une règle de pare-feu uniquement parce qu'une requête indique qu'il s'agit d'un robot particulier. Examiner les codes de statut et le chemin exact demandé avec la personne responsable du site ; une limite de débit, une redirection, une politique d'accès ou une erreur de serveur peuvent expliquer l'échec d'une requête sans prouver ce qu'un assistant aurait répondu.
Des objectifs différents nécessitent des décisions différentes
La documentation du robot d'exploration d'OpenAI distingue OAI-SearchBot, utilisé pour la découverte de recherche, de GPTBot, associé au contenu pouvant être utilisé pour l’entraînement. ChatGPT-User est associé aux requêtes déclenchées par l'utilisateur. Ces étiquettes décrivent les objectifs déclarés du fournisseur, et non une taxonomie universelle pour chaque entreprise. Les décisions concernant l’accès à la recherche et l’entraînement sont distinctes ; ne présumez pas que l’autorisation d’un agent utilisateur autorise automatiquement chaque utilisation ou garantit l’inclusion dans les résultats de recherche.
Une politique robots.txt communique les préférences d'exploration aux robots d'exploration conformes ; il ne s'agit pas d'un système de contrôle d'accès ni d'un mécanisme de secret. Un pare-feu ou une connexion peut bloquer une demande même si les robots le permettent. À l’inverse, pour empêcher l’accès à des informations véritablement privées, utilisez des contrôles d’accès appropriés. Google explique également que bloquer l'exploration n'est pas la même chose qu'empêcher l'indexation d'une URL ; son mécanisme noindex documenté doit être accessible au robot pour être lu.
Vérifiez l'itinéraire avant de modifier une politique
Commencez par la page publique qui répond à la véritable question du client. Vérifiez l'URL finale après les redirections, le code de réponse, les faits visibles sur le service et si le contenu important est disponible pour le visiteur prévu. Inspectez les règles des robots pertinentes et, avec l'opérateur du site, tous les journaux CDN ou pare-feu. Conservez la configuration précédente et identifiez une restauration avant de modifier l’accès. Une règle d'autorisation large peut affecter plus de chemins que la page que vous aviez l'intention d'exposer.
Choisissez le fournisseur et l'utilisation que vous souhaitez réellement activer, et documentez le compromis avec le propriétaire de l'entreprise. Une annonce payante, une visite de robot ou une demande de page réussie ne constitue pas une promesse de recommandation. Si un fournisseur documente des contrôles de recherche et d’entraînement distincts, évaluez-les séparément. Si la page de service elle-même est erronée ou si l'entreprise ne peut pas répondre à la question, résolvez ce problème plutôt que d'essayer de compenser avec le trafic des robots.
Exemple concret : une entreprise de réparation fictive
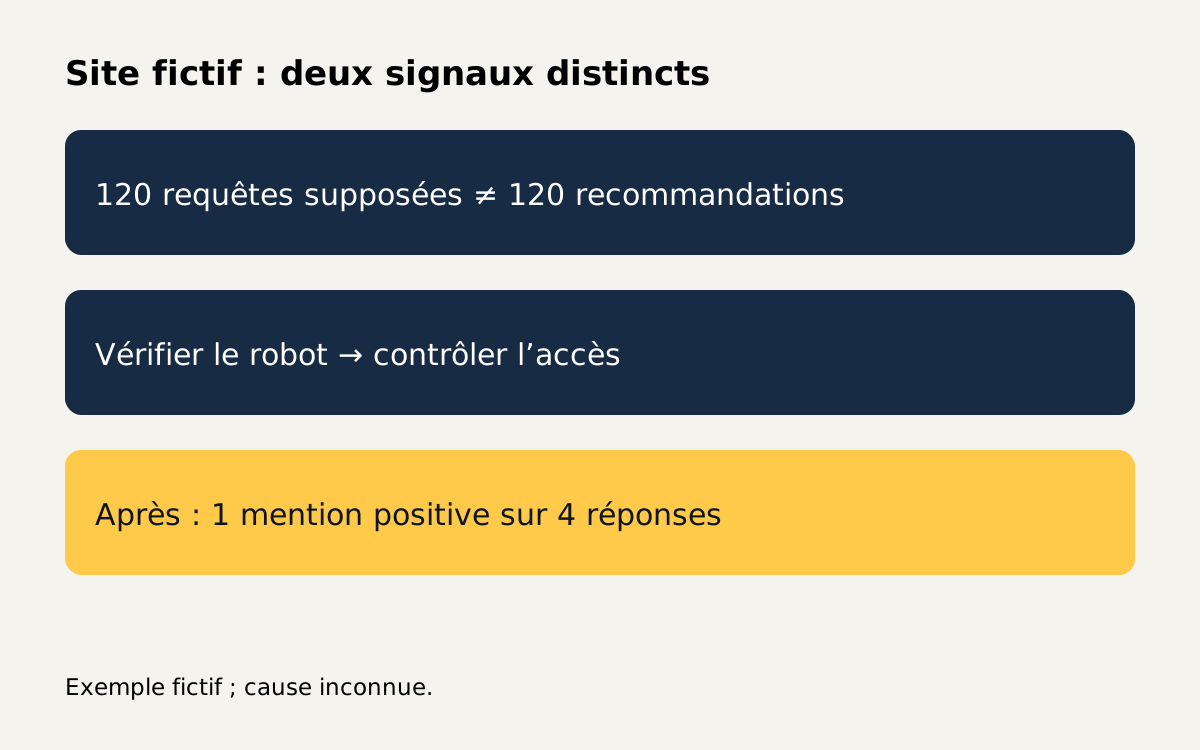
Ceci est un exemple hypothétique, pas un client sayurname ni un résultat mesuré. Ridge Window Repair emploie quatre techniciens dans une ville et possède une page publique sur la réparation des fuites. Le dirigeant voit sur un tableau qu’un supposé robot IA a demandé la page d’accueil 120 fois dans le mois et pense que l’entreprise devrait donc être recommandée. L’équipe vérifie ce que ce nombre démontre sans ouvrir de dossiers clients privés.
L’équipe conserve une base de référence pour une question sans marque sur une fenêtre qui fuit dans sa ville. Dans cette mesure fictive, aucun des quatre assistants disponibles ne nomme Ridge positivement ; l’un renvoie à la page de service en tant que source, deux nomment d’autres entreprises et un donne des conseils généraux. Le lien source n'est pas un nom dans la réponse. Le nombre de journaux et cet ensemble de réponses décrivent différentes choses ; ni l’un ni l’autre n’établit la cause de l’autre.
- Enregistrez la question exacte du client, la ville, la langue, la date, les assistants, les paramètres de recherche visibles et les réponses complètes. Marquez une réponse manquante comme indisponible. Conservez le nombre de réponses disponibles à côté du numéro qui nomme positivement l'entreprise et enregistrez séparément les liens présents uniquement parmi les sources.
- Demandez à l'opérateur du site un échantillon de journal limité montrant les chemins, les heures, les codes de réponse et les agents utilisateurs revendiqués. Évitez d’exporter les dossiers des patients, les informations d’identification ou les données inutiles des visiteurs. Vérifiez le robot d’exploration suspecté par rapport à la procédure publiée par le fournisseur et aux plages d’adresses avant de lui attribuer le trafic.
- Vérifiez l'URL du service important, pas seulement la page d'accueil. Dans l'exemple fictif, une règle robots autorise le robot de recherche, mais une règle CDN renvoie 403 pour ce robot vérifié sur la page de service. Un robot d'exploration de formation distinct a sa propre politique. Le journal établit la réponse observée pour cette demande ; cela ne prouve pas que la page serait autrement sélectionnée.
- Demandez au propriétaire de décider quel accès est prévu. Si un accès à la recherche est souhaité, effectuez une correction CDN de portée étroite avec l'opérateur du site et prévoyez un retour arrière. Ne modifiez pas le réglage distinct concernant l’entraînement simplement comme un effet secondaire. Confirmez la réponse finale du robot d'exploration vérifié à l'aide de la méthode de vérification prise en charge par le fournisseur.
- Répétez régulièrement la question inchangée et enregistrez toutes les réponses disponibles. Dans une série fictive ultérieure, l'un des quatre noms Ridge de manière positive. Séparez tout lien source uniquement et tout résultat indisponible ; une mention négative n’est pas une recommandation positive.
- Examinez ensemble la modification de la configuration, l’accès vérifié et la série de réponses complètes. Le changement de zéro à un nom en deux exécutions inventées ne prouve pas que la correction CDN a provoqué la mention, ne permet pas de calculer une probabilité pour chaque utilisateur et ne prouve pas une vente. D'autres pages, index, modèles et paramètres peuvent avoir changé.
Si le site restreint délibérément un robot d'exploration pour des raisons commerciales, de confidentialité ou de licence, n'annulez pas cette décision simplement pour augmenter le chiffre affiché dans le tableau de bord. Demandez si un sous-ensemble public ou un autre itinéraire documenté sert cet objectif. L’identité et l’utilisation d’un robot peuvent changer, consultez donc la documentation actuelle du fournisseur avant de modifier la politique.
Une mention positive dans une réponse, un lien source, une visite issue d’une IA enregistrée par Analytics connecté et une demande de bot sont des signaux distincts. Chacun peut répondre à une question opérationnelle différente. Un journal est utile pour diagnostiquer l'accès ; ce n'est pas un indicateur fiable des résultats commerciaux.
Sources et vérification
OpenAI décrit ses objectifs d'exploration et ses informations de vérification sur https://developers.openai.com/api/docs/bots. Google explique la distinction entre l'exploration et l'indexation sur https://developers.google.com/search/docs/crawling-indexing/googlebot et documente noindex sur https://developers.google.com/search/docs/crawling-indexing/block-indexing. Ces documents sont spécifiques à chaque prestataire ; vérifiez les autres fournisseurs séparément au lieu de généraliser une règle.
Conservez la demande réelle, le résultat de la vérification, la configuration et les dates pertinentes. Si l'agent revendiqué ne peut pas être vérifié, étiquetez-le comme non vérifié. Si une réponse de l'assistant n'a pas de sources visibles ou ne peut pas être obtenue, enregistrez cette limitation au lieu d'inventer un lien entre une demande et une recommandation. Comparez uniquement les questions et les paramètres que vous pouvez raisonnablement faire correspondre.
Comment travaille sayurname
Le test gratuit envoie une question à ChatGPT, Gemini, Perplexity et Claude et conserve les réponses disponibles. Après abonnement, sayurname travaille les questions, demande l’inclusion lorsqu’une voie existe et mesure chaque semaine. Le forfait coûte 299 $ US par mois sans engagement. Un bonus unique de 599 $ US peut être facturé si une réponse à une question mesurée nomme positivement l’entreprise, absente au départ, ou si Google Analytics connecté enregistre une visite issue d’une IA pendant la prestation. Une personne vérifie la preuve avant facturation. Aucun résultat n’est garanti.
Questions
Une visite vérifiée d’un robot garantit-elle une recommandation ?
Non. Il montre une demande observée par un robot vérifié ; il n'établit pas ce que dira un assistant.
Les robots de recherche et d’entraînement sont-ils nécessairement les mêmes ?
Non. OpenAI documente des agents utilisateurs distincts à des fins différentes. Vérifiez la documentation actuelle du fournisseur concerné et vos propres préférences d’accès.
Le blocage d'un robot rend-il une page privée ?
Non. Les règles des robots ne constituent pas un contrôle d'accès. Utilisez une authentification appropriée ou d’autres contrôles d’accès pour le contenu privé.
Que mesurer en plus des journaux ?
Conservez les réponses complètes et datées à des questions comparables. Notez séparément les mentions, les liens présents seulement parmi les sources et les réponses indisponibles. Analytics connecté peut fournir un autre signal sur les visites.