Pubblicato il 27 ottobre 2026
Le visite del crawler AI significano che un assistente consiglierà la tua attività?
Una richiesta del crawler mostra che un client ha chiesto una risorsa al tuo server; non dimostra che un assistente nominerà o consiglierà la tua attività. Crawler diversi hanno scopi diversi. Controlla la documentazione attuale del provider, verifica un bot sospetto utilizzando il metodo pubblicato e distingui le regole dei robot dal comportamento del firewall. Quindi esamina le risposte complete a una domanda coerente del cliente anziché trasformare il conteggio delle visite in un punteggio di raccomandazione.
Una richiesta non è una raccomandazione
Un registro del server può registrare l'ora, l'URL, il codice di stato e lo user agent dichiarato. Si tratta di una prova operativa che una richiesta ha raggiunto il server o il perimetro, non una prova che la pagina sia stata indicizzata, utilizzata per addestrare un modello, selezionata come fonte o mostrata a un cliente. Una risposta positiva per una home page non dice nulla di per sé sul fatto che la pagina del servizio specifico sia stata recuperata. Una riga mancante ha anche dei limiti: un provider potrebbe utilizzare un indice, un'altra fonte, una cache o un'infrastruttura di cui non è possibile visualizzare i log.
Le stringhe dell'agente utente possono essere imitate. Prima di definire il traffico un crawler ufficiale, utilizza il metodo di verifica e gli indirizzi pubblicati nella documentazione di quel fornitore. Non modificare una regola del firewall solo perché una richiesta indica che si tratta di un bot particolare. Rivedere i codici di stato e l'esatto percorso richiesto con la persona responsabile del sito; un limite di velocità, un reindirizzamento, una policy di accesso o un errore del server possono spiegare una richiesta non riuscita senza dimostrare a cosa avrebbe risposto qualsiasi assistente.
Scopi diversi richiedono decisioni diverse
La documentazione del crawler di OpenAI distingue OAI-SearchBot, utilizzato per la scoperta della ricerca, da GPTBot, associato a contenuti che possono essere utilizzati per l’addestramento. ChatGPT-User è associato alle richieste attivate dall'utente. Queste etichette descrivono gli scopi dichiarati del fornitore, non una tassonomia universale per ogni azienda. Le decisioni sull'accesso alla ricerca e sull’addestramento sono distinte; non dare per scontato che consentire un agente utente autorizzi automaticamente ogni utilizzo o garantisca l'inclusione nei risultati di ricerca.
Una policy robots.txt comunica le preferenze di scansione ai crawler conformi; non è un sistema di controllo degli accessi o un meccanismo di segretezza. Un firewall o un accesso possono bloccare una richiesta anche se i robot lo consentono. Al contrario, per impedire l’accesso a informazioni realmente private, utilizzare controlli di accesso adeguati. Google spiega inoltre che bloccare la scansione non equivale a impedire l'indicizzazione di un URL; il suo meccanismo noindex documentato deve essere accessibile al crawler per essere letto.
Controllare il percorso prima di modificare una politica
Inizia con la pagina pubblica che risponde alla domanda effettiva del cliente. Controlla l'URL finale dopo i reindirizzamenti, il codice di risposta, i fatti visibili del servizio e se i contenuti importanti sono disponibili per il visitatore previsto. Ispeziona le regole dei robot pertinenti e, con l'operatore del sito, eventuali registri CDN o firewall. Conserva la configurazione precedente e identifica un rollback prima di modificare l'accesso. Una regola di autorizzazione ampia può influenzare più percorsi rispetto alla pagina che intendevi esporre.
Decidi quale fornitore e utilizzo desideri effettivamente abilitare e documenta il compromesso con il proprietario dell'azienda. Un'inserzione a pagamento, una visita del crawler o una richiesta di pagina andata a buon fine non costituiscono una promessa di raccomandazione. Se un fornitore documenta controlli di ricerca e addestramento separati, valutali separatamente. Se la pagina del servizio stessa è sbagliata o l'azienda non può rispondere alla domanda, risolvi il problema anziché cercare di compensare con il traffico bot.
Esempio realizzato: un'azienda di riparazioni immaginaria
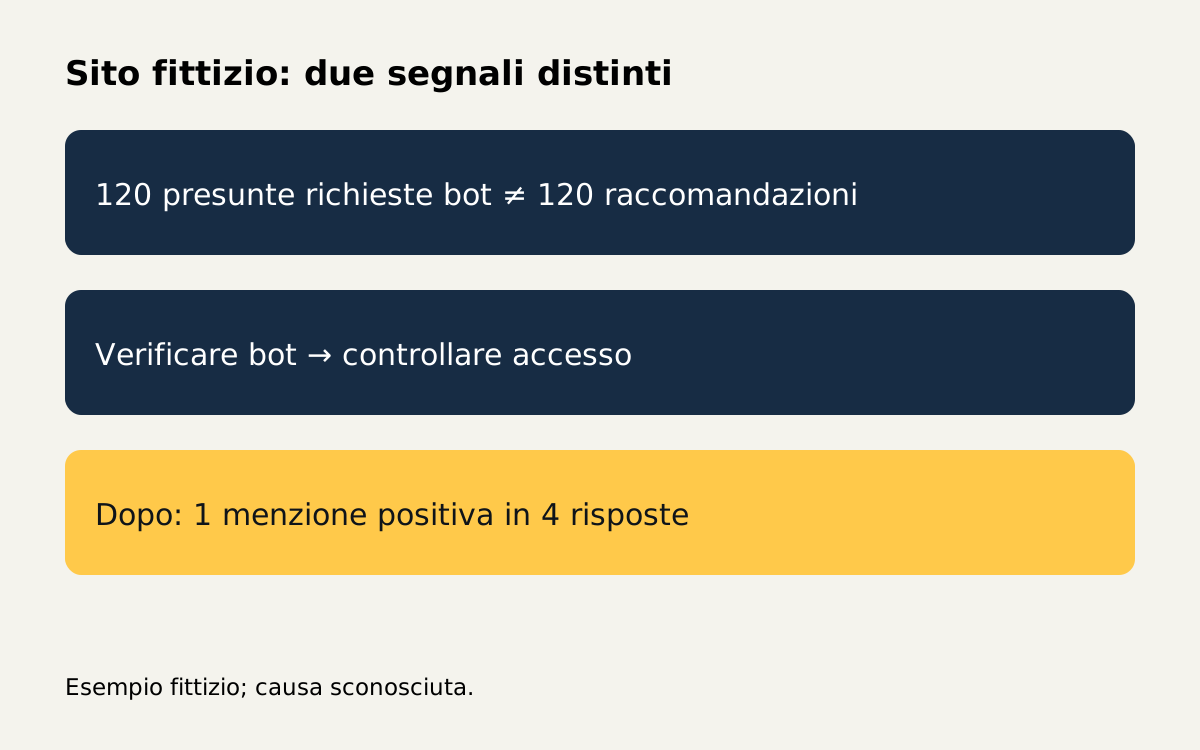
Questo è un esempio ipotetico, non è cliente sayurname né un risultato misurato. Ridge Window Repair ha quattro tecnici in una città e una pagina pubblica sulla riparazione delle perdite. Il titolare vede in un pannello che un presunto bot IA ha richiesto la pagina iniziale 120 volte nel mese e presume che l’attività debba essere raccomandata. Il team verifica cosa dimostra il numero senza aprire registri privati dei clienti.
Il team salva un riferimento per una domanda senza il nome dell’azienda riguardante una finestra che perde nella sua città. In questa prova inventata, nessuno dei quattro assistenti disponibili nomina Ridge in modo positivo; uno si collega alla pagina del servizio come fonte, due nominano altre attività commerciali e uno fornisce consigli generali. Il link della fonte non è un nome nella risposta. Il conteggio dei log e quell'insieme di risposte descrivono cose diverse; nessuno dei due stabilisce la causa dell'altro.
- Registra la domanda esatta del cliente, la città, la lingua, la data, gli assistenti, le impostazioni di ricerca visibili e le risposte complete. Contrassegna una risposta mancante come non disponibile. Mantieni il numero di risposte disponibili accanto al numero che nomina positivamente l'azienda e registra separatamente i collegamenti solo alla fonte.
- Chiedi all'operatore del sito un campione di registro limitato che mostri percorsi, tempi, codici di risposta e user agent dichiarati. Evitare di esportare record di pazienti, credenziali o dati di visitatori non necessari. Verifica il crawler sospetto rispetto alla procedura pubblicata dal provider e agli intervalli di indirizzi prima di attribuirgli il traffico.
- Controlla l'URL del servizio importante, non solo la home page. Nell'esempio fittizio, una regola robots consente il crawler di ricerca, ma una regola CDN restituisce 403 per quel crawler verificato nella pagina del servizio. Un crawler di addestramento separato ha la propria policy. Il registro stabilisce la risposta osservata per quella richiesta; ciò non prova che la pagina verrebbe altrimenti selezionata.
- Chiedi al proprietario di decidere quale accesso è previsto. Se si desidera l'accesso alla ricerca, apportare una correzione CDN con ambito ristretto con l'operatore del sito e mantenere un rollback. Non modificare la preferenza separata relativa all’addestramento semplicemente come effetto collaterale. Conferma la risposta finale per il crawler verificato utilizzando il metodo di verifica supportato dal provider.
- Ripeti la domanda invariata regolarmente e salva tutte le risposte disponibili. In una serie successiva immaginaria, uno dei quattro nomina Ridge positivamente. Mantieni separati i collegamenti solo alla fonte e i risultati non disponibili; una menzione negativa non è una raccomandazione positiva.
- Esamina insieme la modifica della configurazione, l'accesso verificato e la serie di risposte complete. Il cambiamento da zero a un nome in due esecuzioni inventate non dimostra che la correzione CDN abbia causato il nome, non stabilisce una probabilità per ogni utente né dimostra una vendita. Altre pagine, indici, modelli e impostazioni potrebbero essere cambiati.
Se il sito limita deliberatamente un crawler per ragioni aziendali, di privacy o di licenza, non ignorare tale decisione semplicemente per aumentare il numero mostrato nel pannello. Chiedi se un sottoinsieme pubblico o un altro percorso documentato serve allo scopo. L'identità e l'utilizzo di un crawler possono cambiare, quindi consulta la documentazione attuale del provider prima di modificare la policy.
Una menzione positiva in una risposta, un collegamento alla fonte, una visita proveniente da IA registrata dall’Analytics collegato e una richiesta di bot sono segnali separati. Ciascuno può rispondere a una domanda operativa diversa. Un registro è utile per diagnosticare l'accesso; non è un indicatore affidabile del risultato aziendale.
Fonti e verifica
OpenAI descrive gli scopi del crawler e le informazioni di verifica su https://developers.openai.com/api/docs/bots. Google spiega la distinzione tra scansione e indicizzazione su https://developers.google.com/search/docs/crawling-indexing/googlebot e documenta noindex su https://developers.google.com/search/docs/crawling-indexing/block-indexing. Tali documenti sono specifici per ciascun fornitore; controlla gli altri fornitori separatamente invece di generalizzare una regola.
Conserva la richiesta effettiva, il risultato della verifica, la relativa configurazione e le date. Se l'agente dichiarato non può essere verificato, etichettalo come non verificato. Se la risposta di un assistente non ha fonti visibili o non può essere ottenuta, registra tale limitazione invece di inventare un collegamento tra una richiesta e una raccomandazione. Confronta solo le domande e le impostazioni che puoi ragionevolmente abbinare.
Come lavora sayurname
Il test gratuito invia una domanda a ChatGPT, Gemini, Perplexity e Claude e conserva le risposte disponibili. Dopo l’abbonamento sayurname lavora sulle domande, chiede l’inclusione nelle fonti dove possibile e misura ogni settimana. Il canone è 299 USD al mese senza vincoli. Un bonus unico di 599 USD può essere addebitato quando l’attività viene nominata positivamente in una domanda misurata in cui era assente all’inizio, oppure quando Google Analytics collegato registra una visita proveniente da IA durante il servizio. Una persona verifica la prova prima dell’addebito. Nessun risultato è garantito.
Domande
Una visita verificata del crawler garantisce una raccomandazione?
No. Mostra una richiesta osservata da un crawler verificato; non stabilisce cosa dirà un assistente.
I crawler di ricerca e di addestramento sono necessariamente la stessa cosa?
No. I documenti OpenAI separano gli user agent per scopi diversi. Controlla la documentazione attuale del relativo fornitore e le tue preferenze di accesso.
Il blocco di un crawler rende una pagina privata?
No. Le regole dei robot non sono il controllo degli accessi. Utilizzare l'autenticazione appropriata o altri controlli di accesso per i contenuti privati.
Cosa dovrei misurare insieme ai log?
Salva le risposte complete e datate a domande comparabili. Registra separatamente le menzioni, i link presenti solo tra le fonti e le risposte non disponibili. L’Analytics collegato può offrire un segnale diverso sulle visite.