Pubblicato il 17 novembre 2026
Come uno studio capisce se le risposte dell’IA sono davvero cambiate
Ponga le stesse domande, con le stesse parole, ai medesimi quattro assistenti, quattro volte ciascuna, e conti le esecuzioni che citano lo studio. Il cambiamento è reale quando una domanda resta almeno due esecuzioni su quattro sopra la sua prima misurazione in due misurazioni di fila e una domanda di controllo che lo studio non ha toccato non si è mossa. Un’esecuzione su quattro è rumore. Nessuno può promettere il nome, e questa è un’informazione generale, non una consulenza legale.
Un buono screenshot non è una misurazione
Ponga la stessa domanda cinque volte a un assistente e la risposta cambia: un altro ordine, un altro studio, una fonte che prima non c’era. È così che questi sistemi funzionano, non è un difetto. Il socio che apre ChatGPT il lunedì, vede lo studio citato e dice al team che le pagine hanno funzionato ha letto un’esecuzione. Lo stesso socio il giovedì può non vedere lo studio e concludere che il lavoro si è disfatto. Le due letture sono rumore.
Una misurazione è un conteggio su esecuzioni ripetute di domande congelate. Si confronta la quota di esecuzioni che citano lo studio, prima e dopo una modifica, e si decide se il movimento supera il rumore che si vede quando nulla è stato toccato.
Che cosa congelare prima della prima misurazione
Annoti una volta e poi non tocchi più: l’elenco delle domande (fino a dieci, con le parole che un cliente digiterebbe, senza il nome dello studio), il paese e la lingua di ciascuna, i quattro assistenti, il numero di esecuzioni per domanda, cioè quattro, e la data. Conservi ogni risposta per intero, non uno screenshot delle prime righe, perché il nome può comparire al terzo paragrafo o solo nelle fonti.
Aggiunga una domanda di controllo: una materia che lo studio tratta ma su cui non pubblicherà nulla nel periodo. Il controllo dice se si sono mossi gli assistenti stessi. Se passa da zero a tre su quattro senza che nessuna pagina sia cambiata, è stato un aggiornamento del modello, e lo studio non deve prendersene il merito.
Cambiare una parola della domanda, anche solo per farla suonare meglio, apre una domanda nuova con una prima misurazione nuova. Lo si fa per ottenere un numero migliore, ed è il modo più rapido per rendere inutile una serie.
La regola di lettura
Una domanda conta come cambiata quando, sullo stesso assistente, resta almeno due esecuzioni su quattro sopra la sua prima misurazione in due misurazioni di fila. Un’esecuzione su quattro è rumore, e lo è anche una misurazione isolata. Se si è mosso anche il controllo, il cambiamento non è attribuito allo studio.
Poi legga da dove veniva il nome. Se l’assistente cita lo studio e rimanda alla pagina dello studio, la pagina ha fatto il lavoro. Se lo cita a partire da un elenco che già lo riportava, nulla di ciò che ha pubblicato lo ha mosso. La fonte citata è la prova; il nome da solo non lo è.
Non faccia la media dei quattro assistenti in un solo voto. Non si comportano come uno solo, e una cifra come 50% nasconde che due si sono mossi e due no. Tenga una riga per assistente e per domanda.
Un esempio, passo per passo
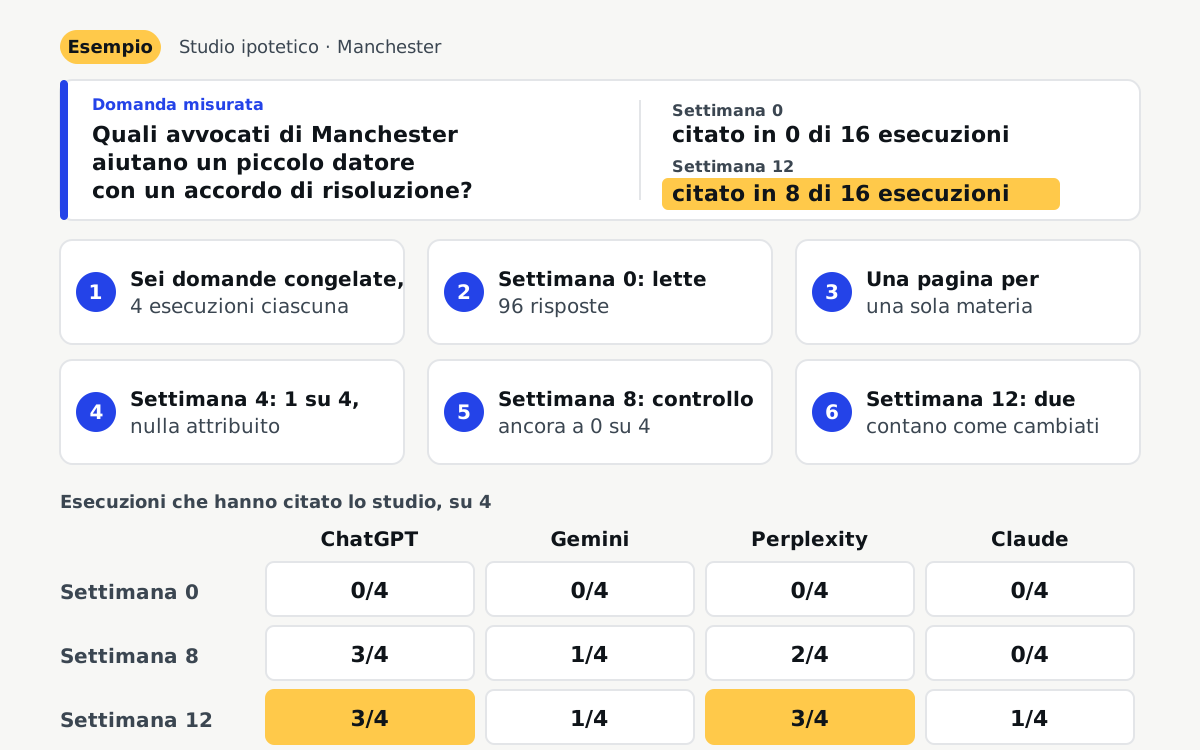
Esempio: uno studio ipotetico, non è un cliente di sayurname. Mersey & Hale è uno studio inventato di diritto del lavoro, con cinque avvocati, a Manchester, che assiste piccoli datori di lavoro. La nota sull’accordo di risoluzione per il datore di lavoro costa £450–£700. Il vecchio sito aveva una pagina «Diritto del lavoro» con un elenco di venti argomenti. La domanda misurata era «Quali avvocati di Manchester aiutano un piccolo datore di lavoro con un accordo di risoluzione?».
Lo studio ha congelato sei domande: cinque di diritto del lavoro e un controllo, sulle locazioni commerciali a Leeds, dove non avrebbe pubblicato nulla. Ciascuna è stata posta quattro volte a ciascuno dei quattro assistenti, cioè 96 risposte a ogni misurazione.
- Ha congelato sei domande, quattro assistenti e quattro esecuzioni ciascuno, e ha conservato ogni risposta per intero con la data.
- Settimana 0: ha letto le 96 risposte. Lo studio non è stato citato in nessuna delle 16 esecuzioni della domanda sull’accordo, né in nessuna del controllo.
- Ha sostituito la pagina dei venti argomenti con una sola pagina sull’accordo di risoluzione: il nome dell’avvocata, dove è abilitata, il link alla consultazione dell’autorità di vigilanza, la forbice da £450 a £700 e ciò che la nota non copre.
- Settimana 4: ChatGPT ha citato lo studio in 1 esecuzione su 4 e gli altri in nessuna. Un’esecuzione su quattro, quindi nulla è stato attribuito.
- Settimana 8: ChatGPT 3 su 4 e Perplexity 2 su 4, Gemini 1 su 4, Claude 0 su 4. Il controllo restava a 0 su 4 su tutti gli assistenti.
- Settimana 12: di nuovo ChatGPT 3 su 4 e Perplexity 3 su 4, quindi entrambi contano come cambiati. Gemini e Claude sono rimasti illeggibili, e la pagina è stata lasciata com’era per altre quattro settimane.
Prima di archiviare il risultato, lo studio ha letto le fonti. Perplexity ha citato la pagina nuova in ogni esecuzione che nominava lo studio. ChatGPT ha citato la pagina in due delle sue tre esecuzioni con il nome e un elenco giuridico nella terza; lo studio ha quindi attribuito alla pagina la maggior parte di quel movimento, non tutto.
Non ha riferito «50% meglio». Ha riferito che due assistenti si sono mossi, due no, e che cosa cambierebbe poi per i due che no. Un altro studio con la stessa pagina potrebbe vedere muoversi prima Gemini, o nulla in dodici settimane.
Quando non misurare di nuovo
Non misuri di nuovo una settimana dopo che una pagina è cambiata. Gli assistenti e le fonti che leggono si aggiornano a velocità diverse. Nell’esempio il primo movimento ha richiesto da quattro a otto settimane, e alcuni studi non ne vedono nessuno in dodici. Una lettura quotidiana disegna un grafico di rumore e invita a riscrivere la pagina a ogni calo.
Uno studio non dovrebbe neppure aprire una serie per una domanda su cui non agirebbe mai. Se non scriverà la pagina, la misurazione registra soltanto, settimana dopo settimana, che è assente. E non allarghi l’elenco mentre una serie è in corso: una domanda nuova ha la propria prima misurazione, separata dalle vecchie.
Come procede il lavoro
Inizia con la prova gratuita. Con l’abbonamento misuriamo fino a 10 domande ogni settimana e pubblichiamo quelli che riteniamo necessari perché l’IA citi il suo studio nelle risposte che vuole. Volume e formato seguono ciò che serve a ogni domanda, e lo decidiamo noi. Chiediamo anche l’inclusione nelle fonti che l’IA usa. Quello che promettiamo è la richiesta, non l’ingresso.
Costa 299 USD al mese, senza vincolo. Un bonus unico di 599 USD si addebita solo quando un’IA inizia a citare lo studio in una domanda misurata, verificato da una persona del nostro team, o quando Google Analytics mostra una visita da un’IA. Lo studio resta responsabile di validare il contenuto giuridico di ciò che si pubblica, e ogni contenuto ha diritto a una revisione. Non è una consulenza e non promette un cliente.
Domande
Quante esecuzioni bastano?
Quattro per assistente e per domanda sono il minimo in questo metodo. Separano nessuna da quasi tutte le esecuzioni. Non separano il 40% dal 50%, e lo studio non deve provarci.
Possiamo interrogare noi gli assistenti, dallo studio?
Può farlo, ma la sua cronologia, la sua posizione e le conversazioni precedenti possono cambiare la risposta. Usi una sessione pulita, la stessa configurazione ogni volta, e conservi la risposta per intero.
E se la domanda di controllo si muove?
Allora si sono mossi gli assistenti, non le pagine dello studio, e il cambiamento non è attribuito. Prosegua con la serie e rilegga alla misurazione successiva.
Con che frequenza misurare?
A mano, una volta al mese basta. Una misurazione settimanale, che fa l’abbonamento, dà quattro letture al mese, e la regola dei due di fila si può applicare prima.
Una risposta cambiata significa nuovi clienti?
No. Significa che l’assistente ora cita lo studio per quella domanda. Che poi qualcuno chiami dipende dalla pagina, dalla consultazione e dalla materia.