Publicado em 29 de outubro de 2026
O llms.txt ajuda os assistentes de IA a recomendar sua empresa?
O llms.txt é uma proposta de arquivo Markdown para orientar a leitura de um site, não uma garantia de descoberta ou indicação. O autor descreve um formato para ajudar agentes a navegar pelas informações. O Google informa que a Pesquisa Google ignora esse arquivo, inclusive nos recursos de busca com IA generativa. Outros produtos podem agir de forma diferente: consulte a documentação do sistema que você usa. Páginas corretas, claras e acessíveis continuam úteis mesmo quando um agente não lê o arquivo.
O que a proposta realmente descreve
A proposta llms.txt descreve um arquivo Markdown legível por humanos e máquinas que fornece informações básicas, orientação e links para material mais detalhado. Sua revisão de 2026 descreve um arquivo na raiz do site ou em um caminho que cobre essa seção; ele também discute links para versões de páginas Markdown. Um arquivo é um conteúdo público, não um canal de instruções secreto. As convenções propostas descrevem o que um autor pode publicar, e não uma obrigação vinculativa para cada rastreador ou assistente.
Um diretório de links só tem valor se o material vinculado permanecer correto, acessível e mantido. Um documento pode ser útil para um agente que é explicitamente orientado a lê-lo, embora não tenha nenhum papel na indexação ou classificação de outro fornecedor. Identifique o consumidor e a tarefa antes de gastar tempo gerando o arquivo. O simples retorno de HTTP 200 para uma URL não prova que algum assistente a consultou.
Separe a Pesquisa Google de outros consumidores
O próprio guia do Google para recursos generativos de IA diz que a Pesquisa Google ignora llms.txt e arquivos especiais semelhantes. O mesmo guia diz que não é necessário um esquema especial para seus recursos de pesquisa generativa. Essa é uma declaração sobre a Pesquisa Google, não uma declaração universal sobre ChatGPT, Claude, cada estrutura de agente ou cada provedor de pesquisa. Não extrapole a documentação de um fornecedor em uma regra para todos os sistemas.
O autor da proposta documenta um formato proposto e exemplos, mas a publicação por um site de documentação não estabelece que um determinado assistente leia ou avalie o arquivo ao responder à pergunta do seu comprador. Procure documentação específica do provedor ou um padrão de acesso autorizado e observável. Se um fornecedor não documentou um comportamento, declare essa limitação em vez de reivindicar adoção universal ou rejeição universal.
O que corrigir antes de criar um diretório
Comece com a página que um cliente em potencial precisa: uma descrição precisa do serviço, onde ele é oferecido, seus limites e uma forma de entrar em contato com a empresa. Verifique se o público-alvo pode acessar a página e se uma parede de login acidental, regra de robôs, erro de servidor ou conflito canônico não impede o caminho de descoberta em questão. Um arquivo público apontando para uma página quebrada ou desatualizada não repara essa página.
Verifique também as datas e a propriedade de referências de terceiros. Você pode atualizar seu próprio site e perfis controlados e pode solicitar a uma fonte independente que corrija sua listagem. A solicitação é uma ação que você pode acompanhar; um editor pode recusar ou ignorar. Uma lista precisa de fontes e um registro do que realmente foi alterado são mais úteis do que uma promessa de que um novo arquivo fará com que um assistente recomende o negócio.
Exemplo resolvido: uma hipotética empresa de reparos
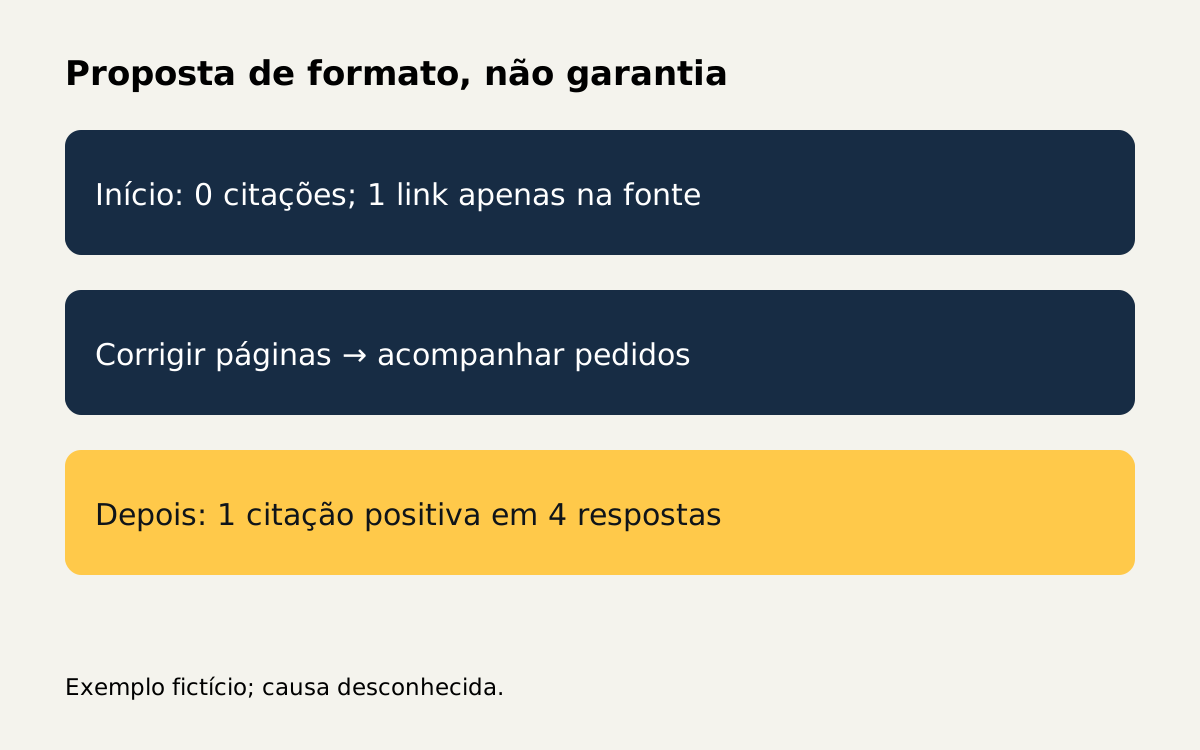
Este é um exemplo fictício, não é cliente da sayurname nem caso medido. A Harbor Window Repair tem quatro técnicos que atendem uma cidade. Sua página descreve conserto de vazamentos em janelas, mas um perfil antigo lista uma região que a empresa já não atende. O dono tem três horas para o projeto e considera criar um llms.txt porque um fornecedor promete que isso trará indicações. Antes de mudar algo, ele escreve uma pergunta de cliente sem a marca e guarda as respostas completas disponíveis das quatro IAs.
Na rodada inicial inventada, nenhuma das quatro respostas disponíveis nomeia a Harbor; uma traz a página do serviço como fonte e duas mencionam concorrentes. Um link apenas nas fontes não é nome na resposta. São observações de uma pergunta numa rodada, não a probabilidade de a empresa ficar ausente para todos. Elas não mostram quais sinais internos cada IA usou.
- Registre a pergunta exata, a data, o assistente, a resposta completa e as configurações de pesquisa visíveis. Mantenha as respostas indisponíveis separadas em vez de contá-las como ausências. Se a pergunta mudar posteriormente, inicie uma série separada com seu próprio ponto de partida.
- Verifique a página de serviço como um cliente faria: confirme se ela abre, se a localização e o reparo oferecidos estão corretos e se existe um caminho de agendamento. Peça ao proprietário para confirmar o limite geográfico e o que a equipe não repara. Mantenha uma cópia datada da página anterior antes de fazer alterações.
- Corrija o perfil desatualizado que você controla. Caso a listagem incorreta pertença a terceiros, envie solicitação de correção pelo canal publicado e registre a data e o status. Não afirme que a correção já está publicada até que o proprietário a altere.
- Decida se um agente identificado ou fluxo de trabalho de documentação precisa de um mapa do site no formato proposto. Em caso afirmativo, crie um arquivo curto com links apenas para páginas públicas relevantes, nomeie um responsável pelas atualizações e exclua informações privadas do cliente. Não adicione apenas porque um vendedor garante uma posição em uma resposta de IA.
- Repita a pergunta sem mudar a redação, em intervalos regulares, e guarde as respostas inteiras. Suponha que numa rodada posterior fictícia uma das quatro IAs disponíveis passe a nomear a Harbor positivamente. Registre separadamente links que aparecem só nas fontes e respostas indisponíveis; uma menção negativa não é indicação positiva.
- Na revisão, compare a mudança de página datada, a solicitação de listagem e as respostas. A menção posterior é uma observação nessa medição. A edição do site, a listagem externa e outras informações poderiam ter mudado juntas, portanto este simples antes e depois não pode estabelecer qual, se houver, causou o resultado.
O proprietário pode achar o pequeno diretório útil para um agente específico, enquanto a Pesquisa Google continua a ignorá-lo. Se nenhum consumidor conhecido precisar do arquivo ou se ninguém conseguir mantê-lo alinhado ao site, o custo de manutenção poderá superar o benefício. Verifique novamente a documentação atual do fornecedor quando o fluxo de trabalho ou a especificação mudar.
Não coloque credenciais, informações não publicadas de clientes ou tokens de acesso em um arquivo público. Não prometa que adicioná-lo causará citação e não trate apenas uma entrada de log do servidor como prova de que um modelo usou o conteúdo em uma resposta. Se a página do serviço estiver inacessível ou a empresa não puder atender a questão honestamente, corrija essa restrição primeiro.
Fontes e como verificar uma afirmação
A proposta em si está em https://llmstxt.org/ e descreve seu escopo e formato. A explicação do Google está em https://developers.google.com/search/docs/fundamentals/ai-optimization-guide e diz respeito aos recursos generativos da Pesquisa Google. Estas fontes respondem a diferentes questões: uma propõe uma convenção, a outra descreve o comportamento de um fornecedor. Leia as duas antes de afirmar que um arquivo llms.txt é obrigatório ou ignorado em todos os lugares.
Uma pequena verificação antes e depois é uma evidência operacional útil, mas não é um experimento controlado: modelos, índices, configurações e outras páginas podem mudar ao mesmo tempo. Salve a pergunta, as datas, as respostas completas, as configurações disponíveis e um registro das alterações. Relate o número de respostas disponíveis ao lado do número de menções positivas e evite atribuir uma alteração ao arquivo sem evidências mais fortes.
Como a sayurname trabalha
O teste grátis envia uma pergunta ao ChatGPT, Gemini, Perplexity e Claude e guarda as respostas disponíveis. Após a assinatura, a sayurname trabalha as perguntas, pede inclusão nas fontes onde houver caminho e mede semanalmente. A mensalidade é R$ 1.490 sem fidelidade. Um bônus único de R$ 2.990 pode ser cobrado se a IA passar a citar positivamente o negócio em uma pergunta medida na qual ele estava ausente no ponto de partida, ou se o Google Analytics conectado registrar uma visita de IA durante o serviço. Uma pessoa da equipe confere a prova antes da cobrança. Nenhum resultado é garantido.
Perguntas
A Pesquisa Google usa llms.txt para AI Overviews?
O Google informa que a Pesquisa ignora llms.txt e arquivos especiais semelhantes, inclusive nos recursos de busca com IA generativa. Consulte o guia atual para verificar mudanças posteriores.
Isso significa que nenhum produto de IA lê o arquivo?
Não. A declaração do Google é sobre a Pesquisa Google. Outra ferramenta ou agente direcionado explicitamente ao arquivo pode se comportar de maneira diferente; verifique o fornecedor e o fluxo de trabalho relevantes.
Um arquivo garantirá uma recomendação?
Não. Um diretório proposto não controla a resposta de uma IA independente nem garante que a IA leia o arquivo.
Quando uma empresa deve ignorá-lo?
Quando nenhum fluxo de trabalho conhecido precisa dele, as páginas vinculadas precisam ser corrigidas primeiro ou ninguém poderá manter o arquivo. Nunca publique dados privados em um arquivo público.