Veröffentlicht am 29. Oktober 2026
Hilft llms.txt KI-Assistenten dabei, Ihr Unternehmen weiterzuempfehlen?
llms.txt ist ein vorgeschlagener Markdown-Wegweiser für eine Website, keine Garantie für Auffindbarkeit oder Empfehlung. Sein Autor beschreibt ein Format, das Agenten bei der Navigation helfen soll. Google erklärt, dass die Google-Suche die Datei auch für ihre generativen KI-Suchfunktionen ignoriert. Andere Produkte können anders handeln: Prüfen Sie die Dokumentation des jeweiligen Systems. Korrekte, klare und zugängliche Seiten bleiben auch dann nützlich, wenn ein Agent die Datei nicht liest.
Was der Vorschlag eigentlich beschreibt
Der llms.txt-Vorschlag beschreibt eine menschen- und maschinenlesbare Markdown-Datei, die Hintergrundinformationen, Anleitungen und Links zu detaillierterem Material bietet. Die Überarbeitung von 2026 beschreibt eine Datei im Stammverzeichnis der Site oder unter einem Pfad, der diesen Abschnitt abdeckt. Außerdem werden Links zu Markdown-Versionen von Seiten besprochen. Eine Datei ist öffentlicher Inhalt und kein geheimer Befehlskanal. Die vorgeschlagenen Konventionen beschreiben, was ein Autor veröffentlichen darf, und stellen keine verbindliche Verpflichtung für jeden Crawler oder Assistenten dar.
Ein Linkverzeichnis hat nur dann einen Wert, wenn das verlinkte Material korrekt, zugänglich und gepflegt bleibt. Ein Dokument kann für einen Agenten nützlich sein, der ausdrücklich angewiesen wird, es zu lesen, ohne an der Indexierung oder dem Ranking eines anderen Anbieters beteiligt zu sein. Identifizieren Sie das nutzende System und die Aufgabe, bevor Sie Zeit mit der Generierung der Datei verbringen. Die bloße Rückgabe von HTTP 200 für eine URL beweist nicht, dass ein Assistent sie konsultiert hat.
Trennen Sie die Google-Suche von anderen Verbrauchern
Googles eigener Leitfaden zu generativen KI-Funktionen besagt, dass die Google-Suche llms.txt und ähnliche spezielle Dateien ignoriert. Im selben Leitfaden heißt es, dass für die generativen Suchfunktionen kein spezielles Schema erforderlich ist. Das ist eine Aussage über die Google-Suche, keine universelle Aussage über ChatGPT, Claude, jedes Agent-Framework oder jeden Suchanbieter. Extrapolieren Sie die Dokumentation eines Anbieters nicht in eine Regel für alle Systeme.
Der Autor des Vorschlags dokumentiert ein vorgeschlagenes Format und Beispiele, aber die Veröffentlichung auf einer Dokumentationsseite bedeutet nicht, dass ein bestimmter Assistent die Datei liest oder gewichtet, wenn er die Frage Ihres Käufers beantwortet. Suchen Sie nach anbieterspezifischer Dokumentation oder einem beobachtbaren, autorisierten Zugriffsmuster. Wenn ein Anbieter ein Verhalten nicht dokumentiert hat, geben Sie diese Einschränkung an, anstatt eine allgemeine Akzeptanz oder allgemeine Ablehnung zu behaupten.
Was vor dem Erstellen eines Verzeichnisses behoben werden muss
Beginnen Sie mit der Seite, die ein potenzieller Kunde benötigt: eine genaue Beschreibung der Dienstleistung, wo sie angeboten wird, ihre Grenzen und eine Möglichkeit, mit dem Unternehmen Kontakt aufzunehmen. Stellen Sie sicher, dass die beabsichtigte Zielgruppe die Seite erreichen kann und dass eine versehentliche Login-Blockade, eine Robots-Regel, ein Serverfehler oder ein widersprüchliches Canonical den relevanten Erkennungspfad nicht verhindert. Eine öffentliche Datei, die auf eine defekte oder veraltete Seite verweist, repariert diese Seite nicht.
Überprüfen Sie auch die Daten und den Besitz von Referenzen Dritter. Sie können Ihre eigene Website und kontrollierte Profile aktualisieren und eine unabhängige Quelle bitten, ihren Eintrag zu korrigieren. Die Anfrage ist eine Aktion, die Sie verfolgen können. Ein Redakteur kann es ablehnen oder ignorieren. Eine genaue Quellenangabe und ein Protokoll darüber, was tatsächlich geändert wurde, sind sinnvoller als das Versprechen, dass eine neue Datei einen Assistenten dazu veranlassen wird, das Unternehmen weiterzuempfehlen.
Ausgearbeitetes Beispiel: ein hypothetischer Reparaturbetrieb
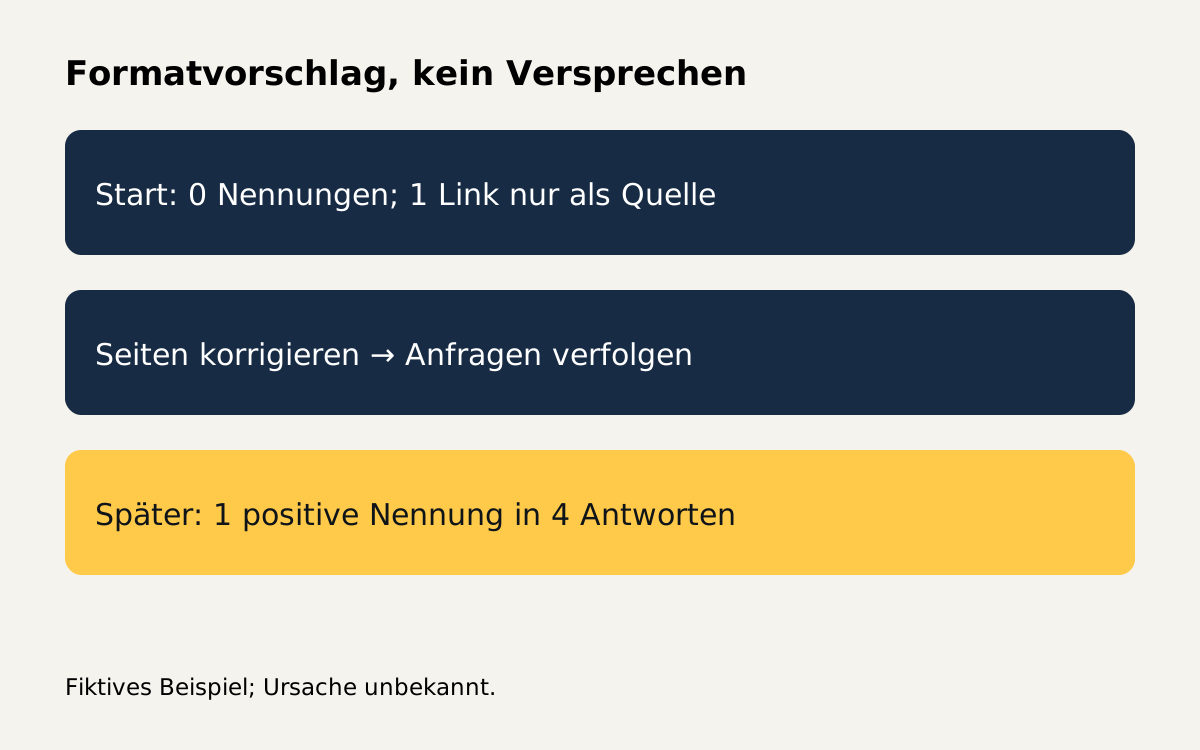
Dies ist ein fiktives Beispiel, kein sayurname-Kunde und kein gemessener Fall. Harbor Window Repair beschäftigt vier Techniker in einer Stadt. Seine Serviceseite beschreibt die Reparatur undichter Fenster; ein altes Profil nennt aber ein Gebiet, das der Betrieb nicht mehr bedient. Der Inhaber hat drei Stunden und erwägt eine llms.txt-Datei, weil ein Anbieter Empfehlungen verspricht. Vor Änderungen formuliert er eine Kundenfrage ohne Marke und speichert die verfügbaren vollständigen Antworten der vier KIs.
Im erfundenen ersten Lauf nennt keine der vier verfügbaren Antworten Harbor; eine verlinkt die Serviceseite als Quelle, zwei erwähnen Wettbewerber. Ein Link nur unter Quellen ist kein Name in der Antwort. Das sind Beobachtungen einer Frage in einem Lauf, keine Wahrscheinlichkeit für alle Nutzer. Sie zeigen nicht, welche internen Signale die einzelnen KIs verwendeten.
- Notieren Sie die genaue Frage, das Datum, den Assistenten, die vollständige Antwort und die sichtbaren Sucheinstellungen. Halten Sie nicht verfügbare Antworten getrennt, anstatt sie als Abwesenheiten zu zählen. Wenn sich die Frage später ändert, beginnen Sie eine separate Serie mit einer eigenen Grundlinie.
- Überprüfen Sie die Serviceseite wie ein Kunde: Vergewissern Sie sich, dass sie geöffnet wird, dass der Standort und die angebotene Reparatur korrekt sind und dass ein Terminpfad vorhanden ist. Bitten Sie den Eigentümer, die geografische Grenze zu bestätigen und anzugeben, was das Team nicht repariert. Bewahren Sie eine datierte Kopie der vorherigen Seite auf, bevor Sie Änderungen vornehmen.
- Korrigieren Sie das veraltete Profil, das Sie kontrollieren. Wenn der falsche Eintrag einem Dritten gehört, senden Sie eine Korrekturanfrage über den veröffentlichten Kanal und notieren Sie Datum und Status. Behaupten Sie nicht, dass die Korrektur aktiv ist, bis der Eigentümer sie ändert.
- Entscheiden Sie, ob ein identifizierter Agent oder Dokumentationsworkflow eine Sitemap im vorgeschlagenen Format benötigt. Wenn dies der Fall ist, erstellen Sie eine kurze Datei, die nur auf relevante öffentliche Seiten verweist, einen Eigentümer für Aktualisierungen benennt und private Kundeninformationen ausschließt. Fügen Sie es nicht hinzu, nur weil ein Verkäufer eine Position in einer KI-Lösung garantiert.
- Stellen Sie die unveränderte Frage regelmäßig erneut und speichern Sie ganze Antworten. Angenommen, in einem späteren fiktiven Lauf nennt eine der vier verfügbaren KIs Harbor positiv. Erfassen Sie Links nur unter Quellen und fehlende Antworten getrennt; eine negative Erwähnung ist keine positive Empfehlung.
- Vergleichen Sie bei der Überprüfung die datierte Seitenänderung, die Korrekturanfrage und die Antworten. Die spätere Nennung ist eine Beobachtung in diesem Lauf. Die Website-Bearbeitung, die externe Auflistung und andere Informationen könnten sich gemeinsam geändert haben, sodass dieses einfache Vorher-Nachher-Bild nicht feststellen kann, was, wenn überhaupt, das Ergebnis verursacht hat.
Der Eigentümer findet das kleine Verzeichnis möglicherweise für einen bestimmten Agenten nützlich, während die Google-Suche es weiterhin ignoriert. Wenn kein bekannter Verbraucher die Datei benötigt oder niemand sie mit der Website in Einklang bringen kann, können die Wartungskosten den Nutzen überwiegen. Überprüfen Sie die aktuelle Dokumentation des Anbieters erneut, wenn sich der Workflow oder die Spezifikation ändert.
Legen Sie Anmeldeinformationen, unveröffentlichte Kundeninformationen oder Zugriffstoken nicht in einer öffentlichen Datei ab. Versprechen Sie nicht, dass das Hinzufügen zu Nennungen führt, und betrachten Sie einen Serverprotokolleintrag nicht allein als Beweis dafür, dass ein Modell den Inhalt in einer Antwort verwendet hat. Wenn die Serviceseite nicht zugänglich ist oder das Unternehmen die Frage nicht ehrlich beantworten kann, beheben Sie zunächst diese Einschränkung.
Quellen und wie man eine Behauptung überprüft
Der Vorschlag selbst ist unter https://llmstxt.org/ zu finden und beschreibt seinen Umfang und sein Format. Die Erklärung von Google finden Sie unter https://developers.google.com/search/docs/fundamentals/ai-optimization-guide und betrifft die generativen Funktionen der Google-Suche. Diese Quellen beantworten unterschiedliche Fragen: Die eine schlägt eine Konvention vor, die andere beschreibt das Verhalten eines Anbieters. Lesen Sie beides, bevor Sie behaupten, dass eine llms.txt-Datei erforderlich ist oder überall ignoriert wird.
Eine kleine Vorher-Nachher-Überprüfung ist ein nützlicher Betriebsnachweis, aber es handelt sich nicht um ein kontrolliertes Experiment: Modelle, Indizes, Einstellungen und andere Seiten können sich gleichzeitig ändern. Speichern Sie die Frage, Daten, vollständige Antworten, verfügbare Einstellungen und eine Aufzeichnung der Änderungen. Geben Sie neben der Anzahl der positiven Nennungen auch die Anzahl der verfügbaren Antworten an und vermeiden Sie die Zuschreibung einer Änderung an der Datei ohne stichhaltige Beweise.
Wie sayurname arbeitet
Der kostenlose Test stellt eine Frage an ChatGPT, Gemini, Perplexity und Claude und speichert die verfügbaren Antworten. Nach dem Abo bearbeitet sayurname die Fragen, beantragt, wo möglich, die Aufnahme in Quellen und misst wöchentlich. Der Preis beträgt 299 US$ pro Monat ohne Mindestlaufzeit. Ein einmaliger Bonus von 599 US$ kann fällig werden, wenn das Unternehmen bei einer gemessenen Frage erstmals positiv genannt wird, bei der es zu Beginn fehlte, oder wenn das verbundene Google Analytics während der Leistung einen KI-Besuch erfasst. Ein Teammitglied prüft den Beleg vor der Abrechnung. Kein Ergebnis ist garantiert.
Fragen
Verwendet die Google-Suche llms.txt für AI Overviews?
Google erklärt, dass die Suche llms.txt und ähnliche Spezialdateien auch für generative KI-Suchfunktionen ignoriert. Prüfen Sie den aktuellen Leitfaden auf spätere Änderungen.
Bedeutet das, dass kein KI-Produkt die Datei jemals liest?
Nein. Die Aussage von Google bezieht sich auf die Google-Suche. Ein anderes Tool oder ein explizit auf die Datei gerichteter Agent kann sich anders verhalten; Überprüfen Sie den relevanten Anbieter und Workflow.
Garantiert eine Datei eine Empfehlung?
Nein. Ein vorgeschlagenes Seitenverzeichnis kontrolliert keine Antwort einer unabhängigen KI und garantiert nicht, dass die KI die Datei liest.
Wann sollte ein Unternehmen darauf verzichten?
Wenn kein bekannter Workflow die Datei benötigt, zuerst verlinkte Seiten korrigiert werden müssen oder niemand die Datei pflegen kann. Veröffentlichen Sie niemals private Daten in einer öffentlichen Datei.