Publié le 29 octobre 2026
llms.txt aide-t-il les assistants IA à recommander votre entreprise ?
llms.txt est une proposition de fichier Markdown destiné à guider la lecture d’un site, pas une garantie de découverte ou de recommandation. Son auteur décrit un format pour aider les agents à parcourir l’information. Google indique que Google Search ignore ce fichier, y compris dans ses fonctions de recherche avec IA générative. D’autres produits peuvent agir autrement : consultez la documentation du système concerné. Des pages exactes, claires et accessibles restent utiles même si un agent ne lit pas le fichier.
Ce que décrit réellement la proposition
La proposition llms.txt décrit un fichier Markdown lisible par l'homme et la machine qui fournit des informations générales, des conseils et des liens vers des documents plus détaillés. Sa révision 2026 décrit un fichier à la racine du site ou sous un chemin couvrant cette section ; il traite également des liens vers les versions Markdown des pages. Un fichier est un contenu public et non un canal d'instructions secret. Les conventions proposées décrivent ce qu'un auteur peut publier, et ne constituent pas une obligation contraignante pour chaque robot ou assistant.
Une liste de liens n’a de valeur que si le matériel lié reste correct, accessible et maintenu. Un document peut être utile à un agent qui est explicitement invité à le lire sans jouer aucun rôle dans l’indexation ou le classement d’un autre fournisseur. Identifiez le consommateur et la tâche avant de passer du temps à générer le fichier. Le simple fait de renvoyer HTTP 200 pour une URL ne prouve pas qu'un assistant l'ait consultée.
Séparez la recherche Google des autres consommateurs
Le propre guide de Google sur les fonctionnalités d'IA générative indique que la recherche Google ignore llms.txt et les fichiers spéciaux similaires. Le même guide indique qu'un schéma spécial n'est pas requis pour ses fonctionnalités de recherche générative. Il s'agit d'une déclaration concernant la recherche Google, et non d'une déclaration universelle concernant ChatGPT, Claude, chaque framework d'agent ou chaque fournisseur de recherche. N’extrapolez pas la documentation d’un fournisseur pour en faire une règle applicable à tous les systèmes.
L'auteur de la proposition documente un format proposé et des exemples, mais la publication par un site de documentation n'établit pas qu'un assistant particulier lit ou pondère le fichier lorsqu'il répond à la question de votre acheteur. Recherchez une documentation spécifique au fournisseur ou un modèle d'accès observable et autorisé. Si un fournisseur n'a pas documenté un comportement, indiquez cette limitation au lieu de revendiquer une adoption universelle ou un rejet universel.
Que corriger avant de créer un répertoire
Commencez par la page dont un client potentiel a besoin : une description précise du service, où il est proposé, ses limites et un moyen de contacter l'entreprise. Vérifiez que le public visé peut accéder à la page et qu'un mur de connexion accidentel, une règle de robots, une erreur de serveur ou un conflit canonique n'empêche pas le chemin de découverte concerné. Un fichier public pointant vers une page cassée ou obsolète ne répare pas cette page.
Vérifiez également les dates et la propriété des références tierces. Vous pouvez mettre à jour votre propre site et vos profils contrôlés, et vous pouvez demander à une source indépendante de corriger son listing. La demande est une action que vous pouvez suivre ; un éditeur peut le refuser ou l'ignorer. Une liste précise des sources et un journal de ce qui a réellement été modifié sont plus utiles qu'une promesse qu'un nouveau fichier amènera un assistant à recommander l'entreprise.
Exemple concret : une entreprise de réparation hypothétique
Ceci est un exemple fictif, pas un client sayurname ni un cas mesuré. Harbor Window Repair emploie quatre techniciens dans une ville. Sa page décrit la réparation de fuites de fenêtres, mais un ancien profil indique une zone que l’entreprise ne dessert plus. Le dirigeant dispose de trois heures et envisage un llms.txt car un fournisseur promet des recommandations. Avant toute modification, il écrit une question client sans marque et conserve les réponses intégrales disponibles des quatre IA.
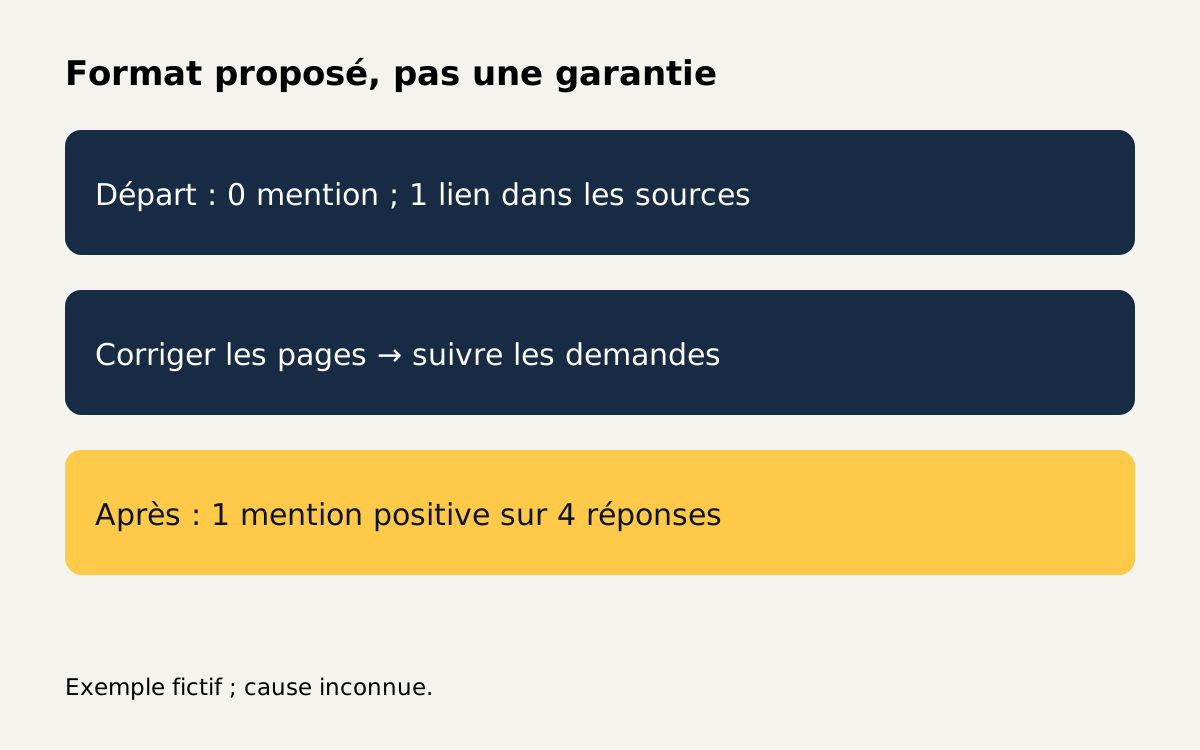
Dans la première série fictive, aucune des quatre réponses disponibles ne nomme Harbor ; une lie la page de service comme source et deux mentionnent des concurrents. Un lien présent seulement parmi les sources n’est pas un nom dans la réponse. Ce sont les observations d’une question sur une série, pas la probabilité d’une absence pour tous. Elles ne révèlent pas les signaux internes utilisés par chaque IA.
- Enregistrez la question exacte, la date, l'assistant, la réponse complète et les paramètres de recherche visibles. Séparez les réponses indisponibles plutôt que de les compter comme des absences. Si la question change plus tard, démarrez une série distincte avec sa propre référence.
- Vérifiez la page de service comme le ferait un client : confirmez qu'elle s'ouvre, que l'emplacement et la réparation proposés sont exacts et qu'un moyen de prendre rendez-vous existe. Demandez au propriétaire de confirmer la limite géographique et ce que l'équipe ne répare pas. Conservez une copie datée de la page précédente avant d’apporter des modifications.
- Corrigez le profil obsolète que vous contrôlez. Si l'annonce incorrecte appartient à un tiers, envoyez une demande de correction via son canal publié et enregistrez la date et le statut. Ne prétendez pas que la correction est active tant que le propriétaire ne la modifie pas.
- Décidez si un agent identifié ou un flux de documentation a besoin d'un plan du site dans le format proposé. Si tel est le cas, créez un fichier court qui renvoie uniquement aux pages publiques pertinentes, nomme un propriétaire pour les mises à jour et exclut les informations privées sur les clients. Ne l'ajoutez pas uniquement parce qu'un vendeur garantit une position dans une réponse IA.
- Répétez régulièrement la question sans changer sa formulation et conservez les réponses intégrales. Supposons que, dans une série fictive ultérieure, une des quatre IA disponibles nomme positivement Harbor. Notez séparément les liens présents seulement parmi les sources et les réponses indisponibles ; une mention négative n’est pas une recommandation positive.
- Lors de l'examen, comparez le changement de page daté, la demande d'inscription et les réponses. La mention ultérieure est une observation lors de cette exécution. La modification du site, la fiche externe et d'autres informations auraient pu changer ensemble, de sorte que ce simple avant et après ne peut pas établir laquelle, le cas échéant, a causé le résultat.
Le propriétaire peut trouver le petit répertoire utile pour un agent spécifique alors que la recherche Google continue de l'ignorer. Si aucun consommateur connu n’a besoin du fichier, ou si personne ne peut le maintenir aligné avec le site, le coût de maintenance peut dépasser les avantages. Vérifiez à nouveau la documentation actuelle du fournisseur lorsque le flux de travail ou les spécifications changent.
Ne placez pas d'informations d'identification, d'informations client non publiées ou de jetons d'accès dans un fichier public. Ne promettez pas que son ajout entraînera une citation, et ne considérez pas une entrée de journal du serveur à elle seule comme une preuve qu'un modèle a utilisé le contenu d'une réponse. Si la page de service est inaccessible ou si l'entreprise ne peut pas répondre honnêtement à la question, corrigez d'abord cette contrainte.
Sources et comment vérifier une affirmation
La proposition elle-même se trouve sur https://llmstxt.org/ et décrit sa portée et son format. L'explication de Google se trouve sur https://developers.google.com/search/docs/fundamentals/ai-optimization-guide et concerne les fonctionnalités génératives de la recherche Google. Ces sources répondent à différentes questions : l’une propose une convention, l’autre décrit le comportement d’un prestataire. Lisez les deux avant de prétendre qu'un fichier llms.txt est requis ou ignoré partout.
Une petite vérification avant et après constitue une preuve opérationnelle utile, mais il ne s'agit pas d'une expérience contrôlée : les modèles, index, paramètres et autres pages peuvent changer en même temps. Enregistrez la question, les dates, les réponses complètes, les paramètres disponibles et un enregistrement des modifications. Indiquez le nombre de réponses disponibles à côté du nombre de mentions positives et évitez d'attribuer un changement au fichier sans preuves plus solides.
Comment travaille sayurname
Le test gratuit envoie une question à ChatGPT, Gemini, Perplexity et Claude et conserve les réponses disponibles. Après abonnement, sayurname travaille les questions, demande l’inclusion lorsqu’une voie existe et mesure chaque semaine. Le forfait coûte 299 $ US par mois sans engagement. Un bonus unique de 599 $ US peut être facturé si une réponse à une question mesurée nomme positivement l’entreprise, absente au départ, ou si Google Analytics connecté enregistre une visite issue d’une IA pendant la prestation. Une personne vérifie la preuve avant facturation. Aucun résultat n’est garanti.
Questions
La recherche Google utilise-t-elle llms.txt pour les aperçus de l'IA ?
Google indique que Search ignore llms.txt et les fichiers spéciaux similaires, y compris dans ses fonctions de recherche avec IA générative. Consultez le guide actuel en cas de changement.
Cela signifie-t-il qu’aucun produit d’IA ne lit jamais le fichier ?
Non. La déclaration de Google concerne la recherche Google. Un autre outil ou un agent explicitement dirigé vers le fichier peut se comporter différemment ; vérifiez le fournisseur et le flux de travail concernés.
Un fichier garantira-t-il une recommandation ?
Non. Un répertoire proposé ne contrôle pas la réponse d’une IA indépendante et ne garantit pas qu’elle lise le fichier.
Quand une entreprise doit-elle l’ignorer ?
Lorsqu’aucun flux connu ne nécessite ce fichier, que les pages liées doivent d’abord être corrigées ou que personne ne peut le maintenir. Ne publiez jamais de données privées dans un fichier public.